🚨 في الخمسينيات… كان هناك حلم غريب جدًا:
ماذا لو استطعنا أن نصنع آلة لا تنفذ التعليمات فقط…
بل تتعلم؟
في ذلك الوقت، الكمبيوتر كان شيئًا مختلفًا تمامًا عن الذي نعرفه اليوم.
آلة ضخمة، غالية، وتنفيذها للأوامر يعتمد على ما يكتبه الإنسان لها.
لو أردت منها أن تميز بين شيئين، كان عليك أن تخبرها بالقواعد بنفسك.
لكن عالمًا أمريكيًا اسمه Frank Rosenblatt كان يفكر في شيء مختلف.
قال:
“ماذا لو جعلنا الآلة تتعلم من الأمثلة بدلًا من أن نخبرها بكل القواعد؟”
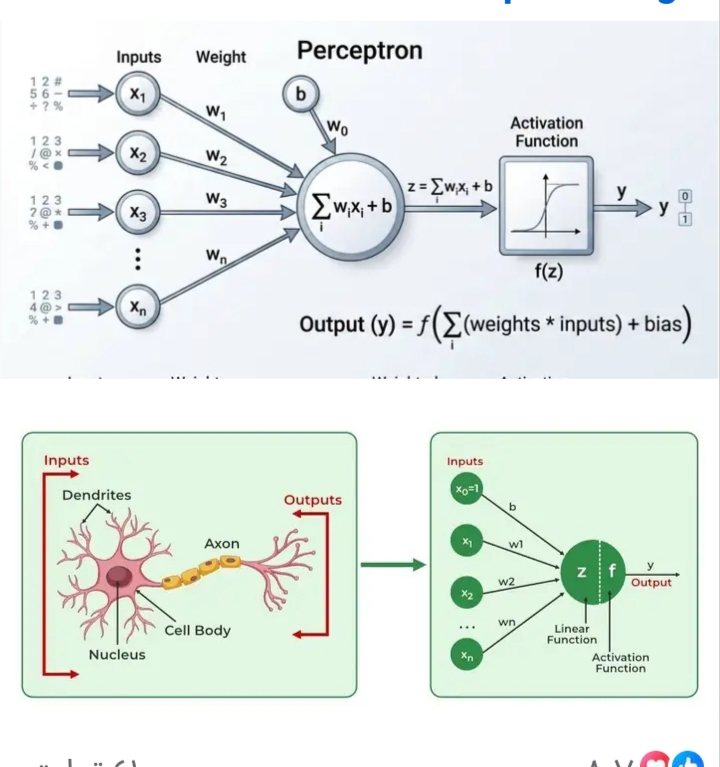
الفكرة كانت مستوحاة جزئيًا من طريقة عمل الخلايا العصبية في الدماغ.
فبدأ يبني نموذجًا بسيطًا جدًا…
ليس ChatGPT.
ولا شبكة عميقة.
ولا حتى نموذجًا معقدًا.
مجرد خلية حسابية صغيرة.
وسماها:
Perceptron 🧠
تخيل أنك تريد من الكمبيوتر أن يقرر:
هل هذه الصورة تحتوي على شكل معين أم لا؟
تعطيه مجموعة من المعلومات.
مثلاً:
📌 هل يوجد خط أفقي؟
📌 هل يوجد خط رأسي؟
📌 هل الحجم كبير؟
📌 هل اللون فاتح؟
الـPerceptron يأخذ هذه المعلومات…
لكن لا يعاملها كلها بنفس الأهمية.
يعطي لكل معلومة Weight.
واحد مهم جدًا 👈 وزن أكبر.
واحد تأثيره ضعيف 👈 وزن أصغر.
ثم يجمع كل شيء.
وفي النهاية يقول:
1 ⬅️ نعم
أو:
0 ⬅️ لا
وهنا ظهرت الفكرة العبقرية:
ماذا لو كانت الأوزان نفسها تتغير أثناء التعلم؟
أعطينا النموذج مثالًا.
قال:
❌ “الإجابة خطأ.”
فيعدل الأوزان.
نعطيه مثالًا آخر.
❌ “ما زالت الإجابة خطأ.”
فيعدلها مرة أخرى.
ثم مثالًا آخر:
✅ “هذه المرة أصبت.”
وهكذا يبدأ النموذج في تعديل نفسه بناءً على أخطائه.
لاحظ شيئًا مهمًا جدًا هنا…
هذا هو نفس المبدأ الذي تحدثنا عنه في المنشور السابق عن:
Gradient Descent
لكن الـPerceptron أقدم وأبسط بكثير، ولا يستخدم Gradient Descent بالشكل الحديث الذي نعرفه في تدريب الشبكات العصبية.
الفكرة المشتركة هي:
«الخطأ ليس نهاية العملية…
الخطأ هو المعلومة التي نستخدمها لتعديل النموذج.»
وفي عام 1957، بدأ Rosenblatt العمل على نموذج عملي للـPerceptron في Cornell Aeronautical Laboratory.
وبعد ذلك ظهر شيء جعل الصحافة تتحمس جدًا.
تم تقديم Mark I Perceptron كآلة قادرة على التعلم من الأمثلة.
والناس بدأت تتخيل المستقبل:
🤖 آلات ترى.
🤖 آلات تسمع.
🤖 آلات تتعلم.
لكن…
🔴 كانت هناك مشكلة كبيرة جدًا.
الـPerceptron كان يستطيع تعلم بعض الأنماط البسيطة، خصوصًا عندما يمكن فصل الفئات بخط مستقيم.
لكن هناك مشاكل لا يستطيع حلها.
وأشهرها مثال رياضي بسيط جدًا:
XOR
لو أعطيت الـPerceptron أمثلة من نوع:
▪️ 0 XOR 0 → 0
▪️ 0 XOR 1 → 1
▪️ 1 XOR 0 → 1
▪️ 1 XOR 1 → 0
فهو لا يستطيع ببساطة أن يرسم خطًا واحدًا يفصل الإجابات الصحيحة عن الخاطئة.
وهنا حدث شيء مهم جدًا في تاريخ الـAI.
ظهر نقد قوي للـPerceptron، وأصبح واضحًا أن نموذجًا بطبقة واحدة لديه حدود حقيقية.
وللحظة…
بدا أن حلم “آلة تتعلم” ربما كان أكبر من الإمكانيات المتاحة.
لكن العلماء لم يتوقفوا.
قالوا:
إذا كانت خلية واحدة لا تكفي…
فماذا لو استخدمنا أكثر من خلية؟
وهنا تبدأ قصة جديدة تمامًا.
Perceptron واحد…
⬇️
عدة Perceptrons
⬇️
Layers
⬇️
Neural Networks
⬇️
Backpropagation
⬇️
Deep Learning
⬇️
وفي النهاية…
الأنظمة التي نتعامل معها اليوم.
والشيء المدهش أن الـPerceptron نفسه كان بسيطًا جدًا مقارنة بما نملكه الآن.
لكن فكرته الأساسية كانت ثورية:
بدل أن تكتب للآلة كل القواعد…
دعها تتعلم القواعد من الأمثلة.
وهنا بدأ الطريق الحقيقي نحو الـMachine Learning.
⁉️ لكن السؤال التالي أصبح أخطر:
إذا كانت لدينا شبكة مكونة من مئات أو آلاف الخلايا…
وعملت الشبكة خطأ، فكيف نعرف أي خلية وأي Weight يجب أن نعدله؟
وهنا…
تبدأ واحدة من أهم القصص في تاريخ الـAI:
Backpropagation 🧠
#The_World_of_Data 💙
#DataScience #DeepLearning
#مجلة ايليت فوتو ارت.